Bỏ qua điều hướng
  1. Trang chủ
  2. Điền theo mô hình nghiên cứu
Dữ liệu nghiên cứu

Mô phỏng dữ liệu theo mô hình nghiên cứu để kiểm thử bảng hỏi và quy trình SPSS, SmartPLS, AMOS

Vẽ mô hình nghiên cứu, gán câu hỏi Google Form vào từng nhân tố, đặt tỷ lệ nhân khẩu học và chọn phần mềm bạn sẽ dùng. Hệ thống sinh bộ dữ liệu mô phỏng khớp với mô hình, tính sẵn các chỉ số theo ngưỡng tham khảo và lập báo cáo mẫu, để bạn kiểm thử bảng hỏi, luyện cách chạy và đọc kết quả trước khi thu thập dữ liệu thật.

Minh họa Điền theo mô hình nghiên cứu

Thông tin nhanh cập nhật

Giá đơn điền form
2,5 / 4,5 / 6 Credit/lượt (<10 / 10–20 / ≥21 câu)
Sinh dữ liệu và báo cáo
Miễn phí, xem trước khi lên đơn
Phần mềm
SPSS, SmartPLS, AMOS, STATA
Xuất file
Word (bảng APA), SPSS .sav có nhãn, CSV SmartPLS, .do STATA, .sps
Xem trong sản phẩm

Chỉ số được kiểm tra trước khi dữ liệu được sử dụng

Thông tin quan trọng được thể hiện bằng trạng thái, tỷ lệ và kết quả kiểm tra thay vì buộc bạn đọc một khối hướng dẫn dài.

≥ 0,70 Alpha / CR
≥ 0,50 AVE
≤ 5,0 VIF
Import form Cấu hình Kiểm tra Tạo đơn
Mô hình trực quan của Điền theo mô hình nghiên cứu
Mô hình và chỉ số được thể hiện trực quan
Phạm vi chức năng

4 bước tạo bộ dữ liệu mô phỏng

Mỗi lần sinh, hệ thống tính các chỉ số thường gặp trên bộ dữ liệu mô phỏng: hệ số tải ngoài, Cronbach's Alpha, CR, AVE, HTMT, Fornell–Larcker, VIF, EFA, CFI, TLI, RMSEA, SRMR, bootstrapping, và so với ngưỡng tham khảo trong tài liệu (Hair et al., 2019; Henseler et al., 2015; Hu & Bentler, 1999). Bộ tính toán được kiểm chứng chéo với thư viện thống kê chuẩn (numpy, scipy, semopy). Dùng để kiểm thử bảng hỏi, luyện quy trình phân tích, làm demo hoặc giảng dạy; không dùng thay dữ liệu thu thập từ người trả lời thật.

Vẽ mô hình: biến độc lập, trung gian, điều tiết, phụ thuộc; hệ số tác động β cho từng giả thuyết; AI đề xuất mô hình từ form.
Gán câu hỏi vào nhân tố, đánh dấu câu đảo ngược và câu sẽ loại khi phân tích (Cronbach lần 1 và lần 2).
Đặt chiều và độ mạnh dự kiến cho từng giả thuyết để mô phỏng các kịch bản kết quả khác nhau khi luyện phân tích.
Đặt tỷ lệ nhân khẩu học (giới tính, tuổi, nghề…) và ràng buộc logic giữa các câu.
Báo cáo SPSS: Cronbach's Alpha, KMO và Bartlett, EFA với ma trận xoay, tương quan Pearson, hồi quy, T-test, ANOVA.
Báo cáo SmartPLS: outer loadings, rho_A, rho_c, AVE, Fornell–Larcker, HTMT, cross-loadings, VIF, R², f², Q², SRMR, bootstrapping 5.000 mẫu.
Báo cáo AMOS: CMIN/df, GFI, CFI, TLI, RMSEA, hệ số tải chuẩn hoá, CR, AVE, MSV, ước lượng SEM; STATA: hồi quy sai số chuẩn vững.
Mỗi bảng ghi ngưỡng, nguồn trích dẫn (Hair et al., 2019; Henseler et al., 2015; Hu & Bentler, 1999…) và một đoạn diễn giải tiếng Việt.
Cách hoạt động

Cách dùng Điền theo mô hình nghiên cứu trong 3 bước

Mỗi bước đều có trạng thái và kiểm tra rõ ràng.

  1. 1

    Vẽ mô hình

    Thêm biến, vẽ mũi tên giả thuyết và đặt hệ số β, hoặc để AI đề xuất.
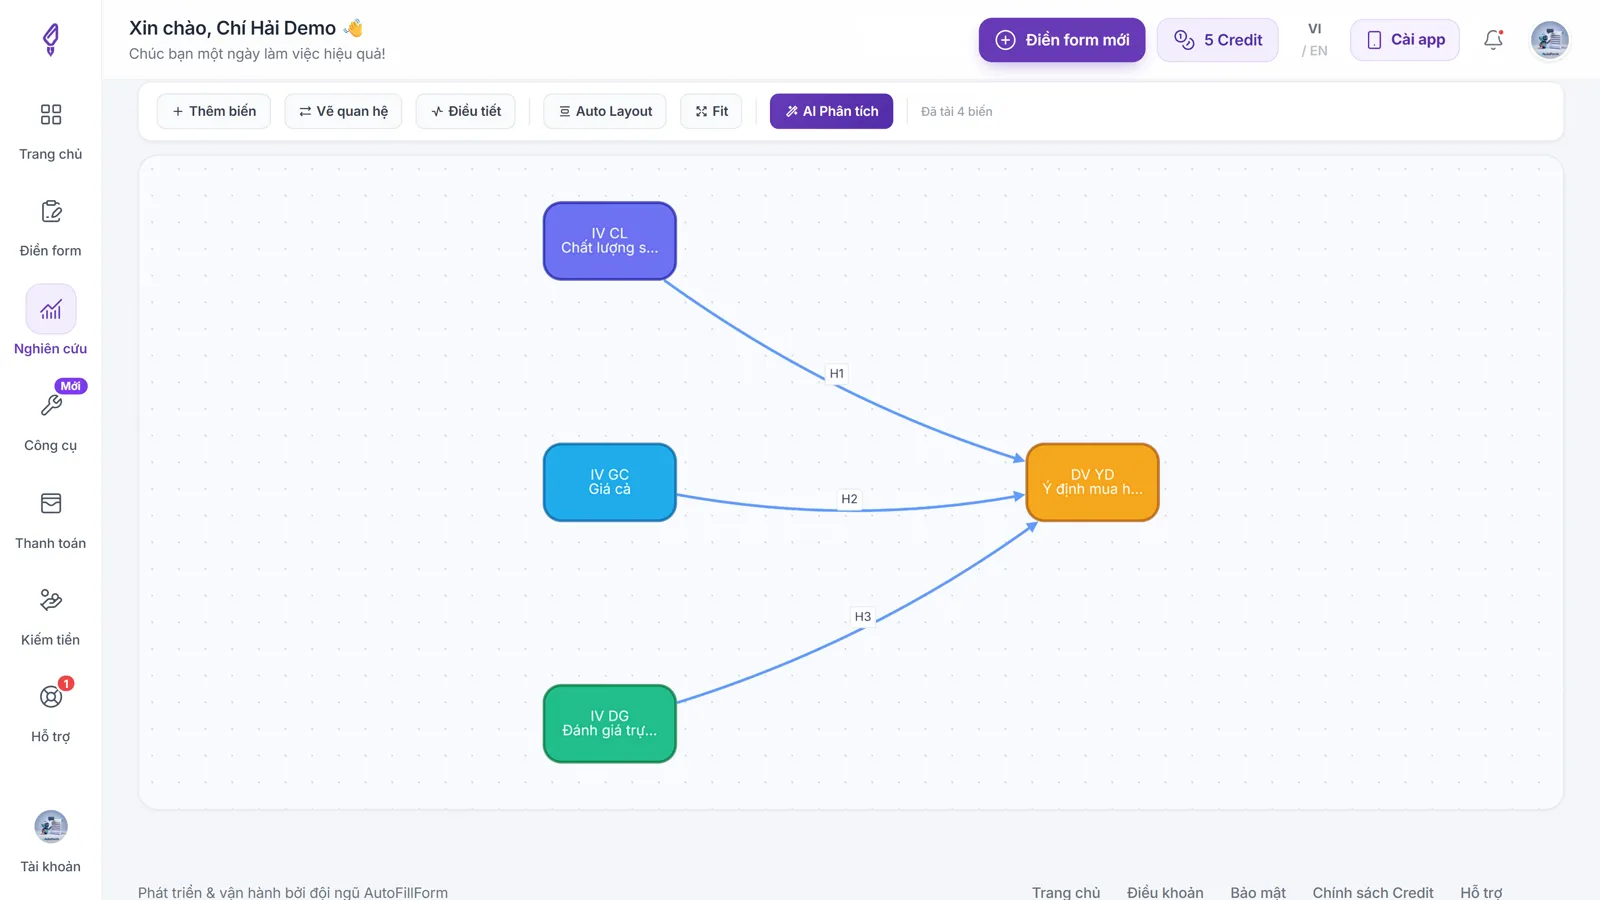
    Bước 1: vẽ mô hình trên canvas, thêm biến, vẽ giả thuyết hoặc để AI phân tích
    Bước 1: vẽ mô hình trên canvas, thêm biến, vẽ giả thuyết hoặc để AI phân tích
  2. 2

    Gán câu hỏi

    Chọn câu hỏi của form cho từng biến, đánh dấu câu đảo ngược, câu loại.
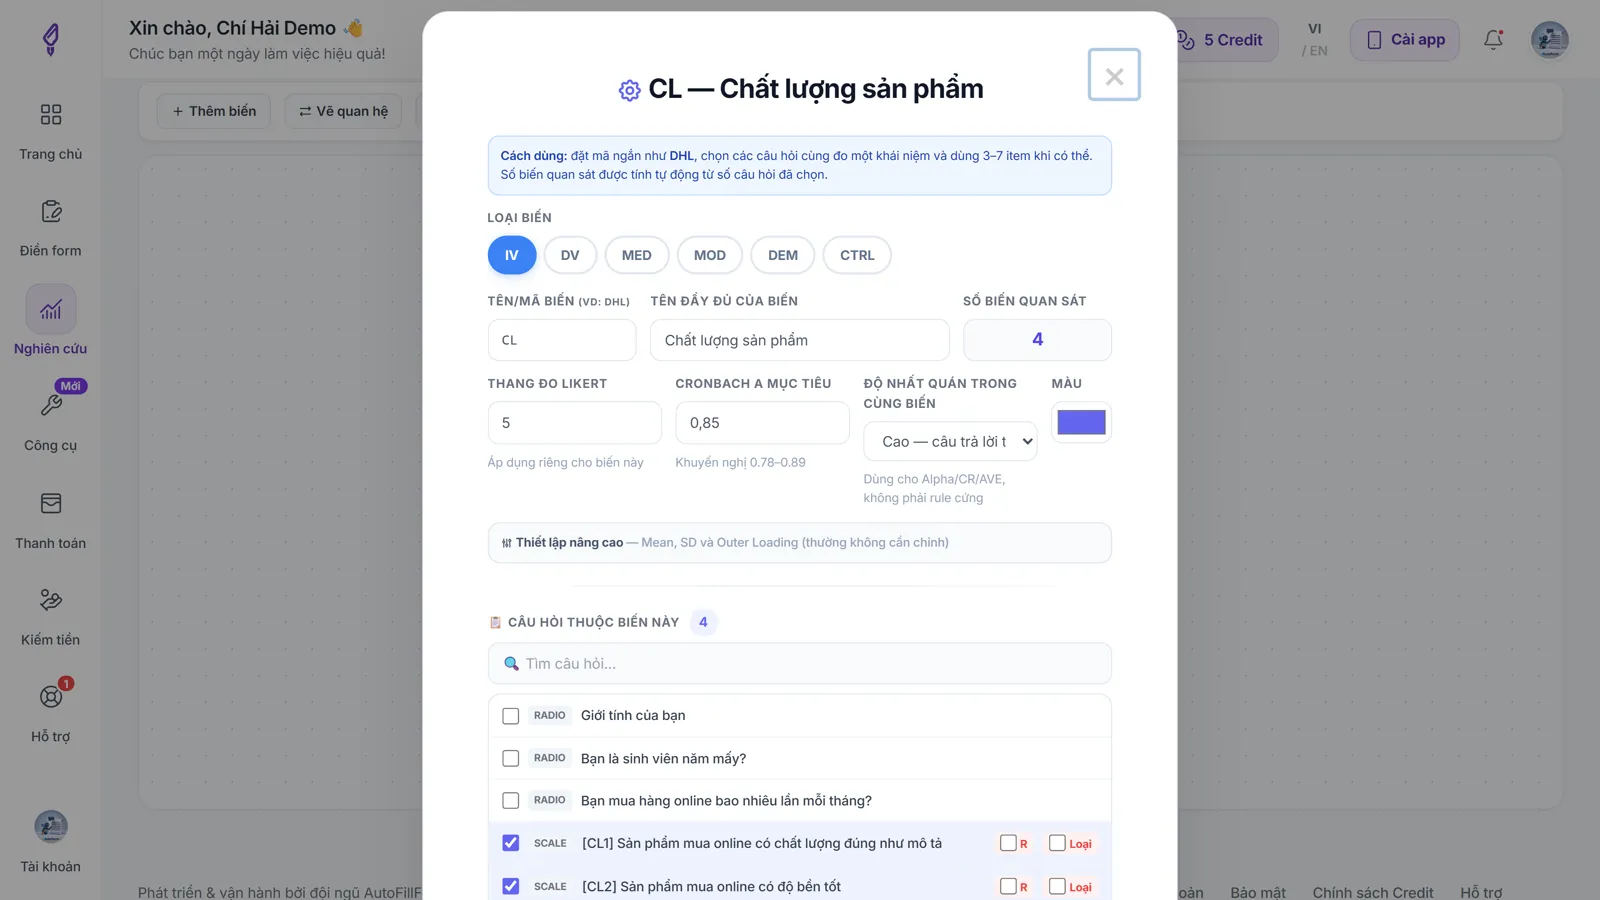
    Bước 2: gán câu hỏi vào biến, đánh dấu câu đảo ngược (R) và câu loại khi phân tích
    Bước 2: gán câu hỏi vào biến, đánh dấu câu đảo ngược (R) và câu loại khi phân tích
  3. 3

    Tỷ lệ nhân khẩu học

    Đặt cơ cấu mẫu cho giới tính, độ tuổi, nghề nghiệp…
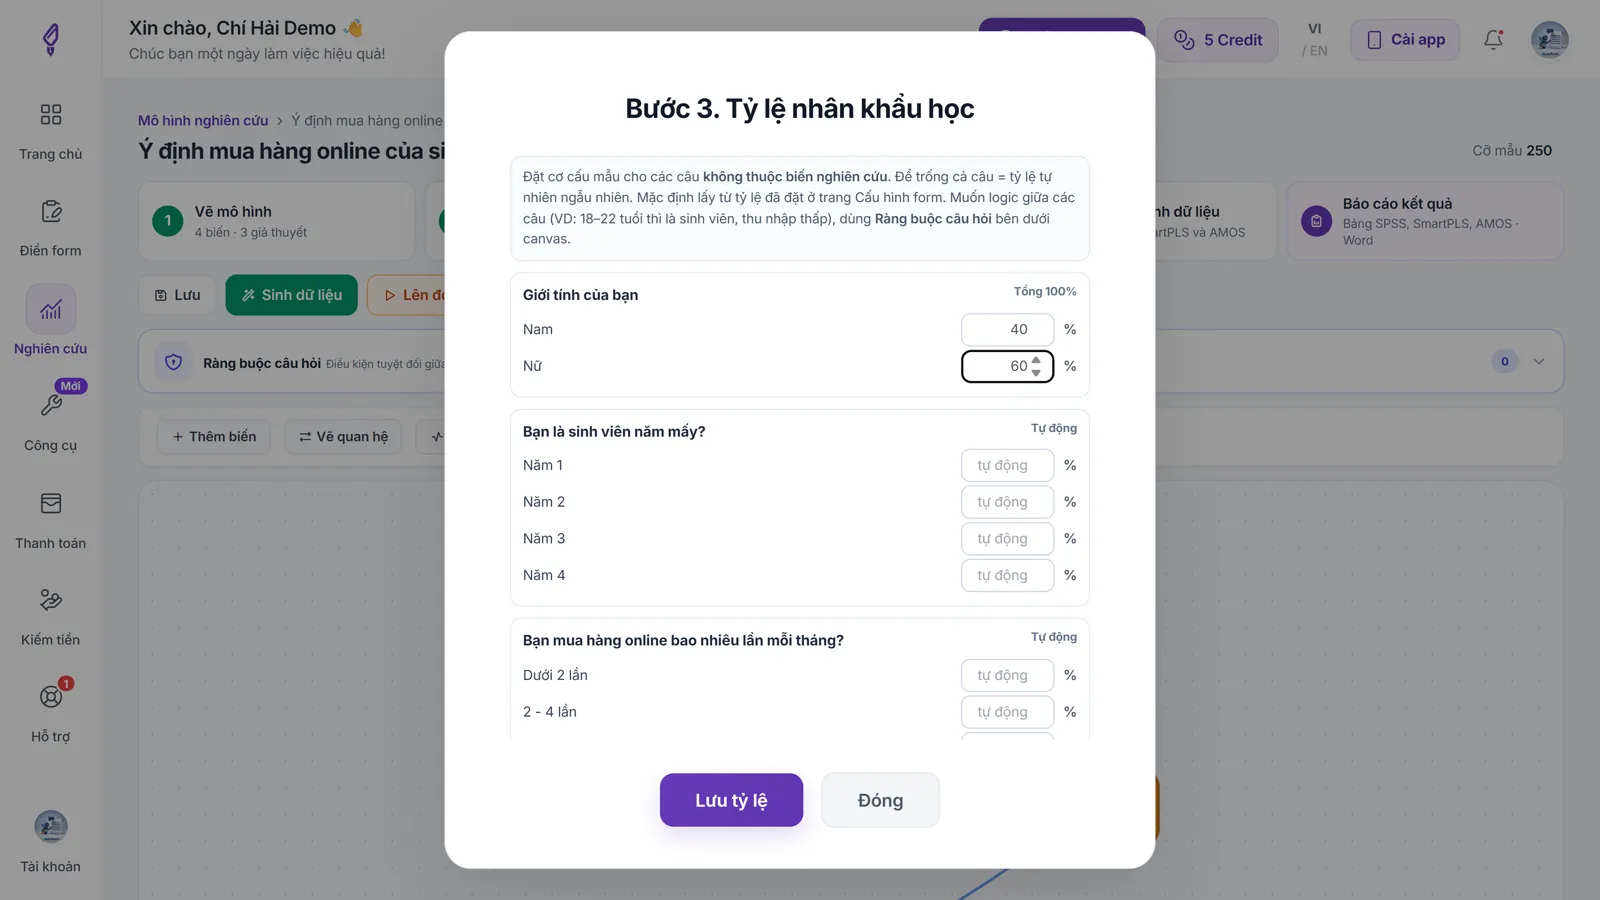
    Bước 3: đặt tỷ lệ nhân khẩu học, ví dụ nam 40%, nữ 60%
    Bước 3: đặt tỷ lệ nhân khẩu học, ví dụ nam 40%, nữ 60%
  4. 4

    Kiểm định và sinh dữ liệu

    Chọn SPSS, SmartPLS, AMOS hoặc cả ba; xem báo cáo, tải Word, rồi lên đơn gửi vào form.
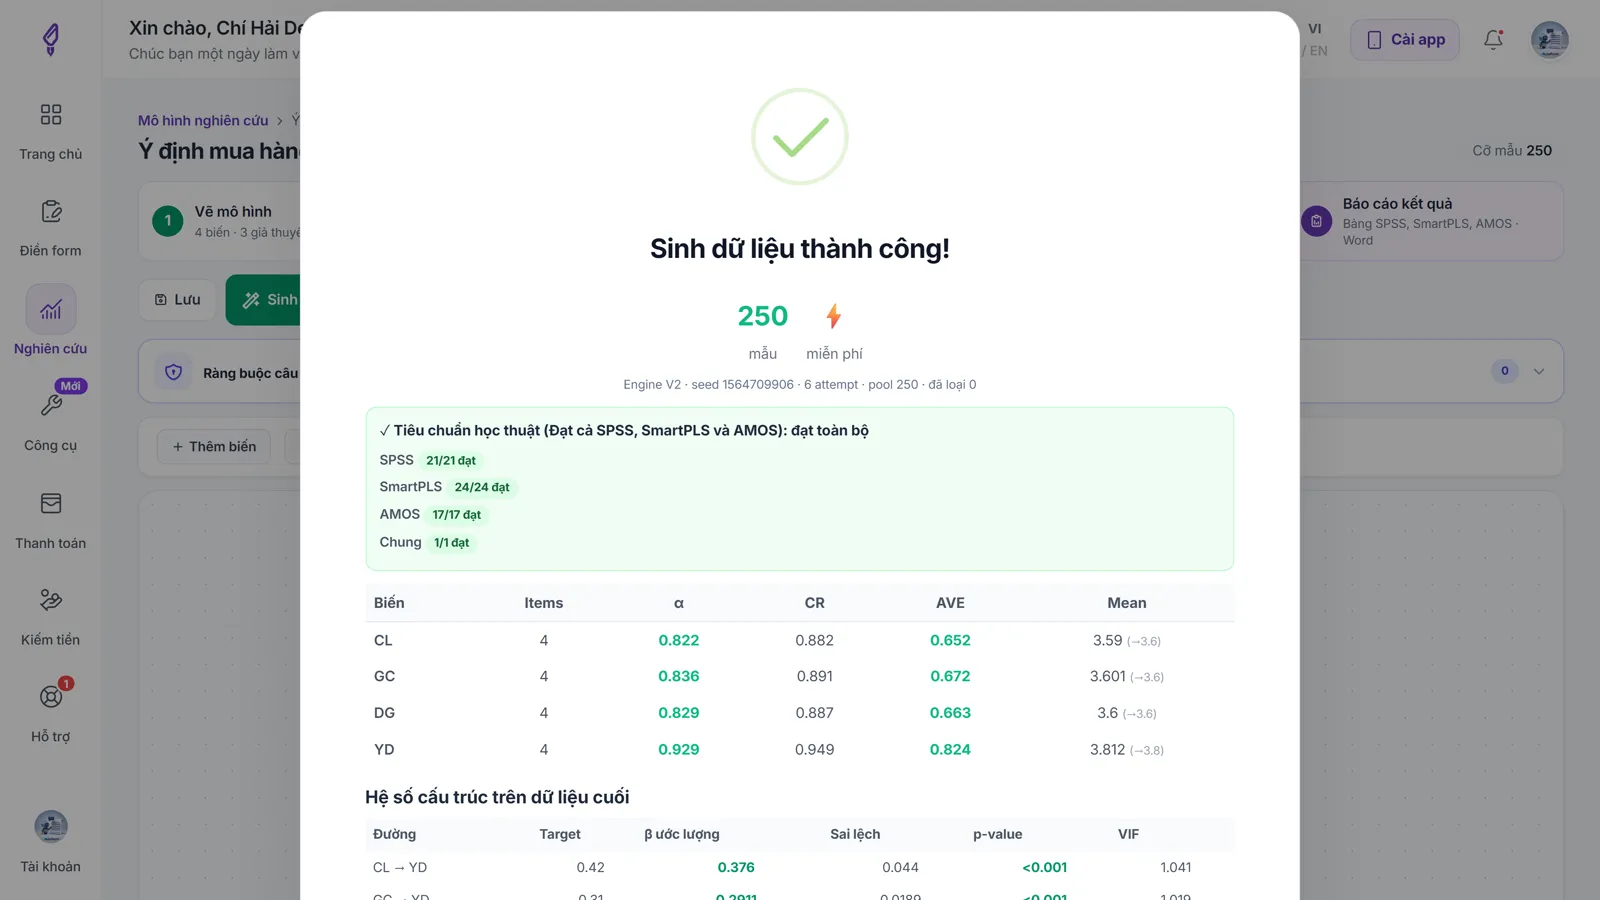
    Bước 4: sinh dữ liệu, SPSS, SmartPLS và AMOS đều đạt toàn bộ tiêu chuẩn học thuật
    Bước 4: sinh dữ liệu, SPSS, SmartPLS và AMOS đều đạt toàn bộ tiêu chuẩn học thuật

Cần chuẩn bị

  • Biểu mẫu có các nhóm câu hỏi đo từng khái niệm, thường là thang Likert 5 hoặc 7 mức.
  • Mô hình không có vòng lặp nhân quả; mỗi biến được gán ít nhất một câu hỏi (nên từ 3 câu).

Giới hạn cần biết

  • Kết quả hỗ trợ kỹ thuật cho việc thu thập và phân tích, không thay thế quyết định phương pháp luận của người nghiên cứu.
  • Dữ liệu sinh ra là dữ liệu mô phỏng, không phải ý kiến của người thật. Không trình bày nó như dữ liệu khảo sát thu thập được trong luận văn, bài báo hay báo cáo (xem Điều khoản sử dụng).
  • Hệ số β quá lớn so với cỡ mẫu (R² tiềm ẩn ≥ 0,92) bị từ chối; khi đó hệ thống ghi rõ cần giảm hệ số nào.
  • EFA gộp toàn bộ thang đo chỉ tách được biến phụ thuộc khi R² của nó không quá cao; cách làm phổ biến là chạy EFA riêng cho nhóm biến độc lập và biến phụ thuộc, báo cáo đã trình bày theo cách đó.
Giải đáp nhanh

Câu hỏi thường gặp

Không. Dữ liệu do hệ thống sinh ra là dữ liệu mô phỏng, không phải câu trả lời của người thật. Chỉ dùng để thử bảng hỏi, luyện phân tích, làm demo; trình bày nó như dữ liệu khảo sát thu thập được là vi phạm liêm chính học thuật và Điều khoản sử dụng.
Báo cáo được tính từ đúng các dòng bạn tải về, cùng công thức phổ biến của phần mềm (PLS mode A, path weighting; CFA ước lượng ML; EFA principal components, Varimax), để bạn đối chiếu khi tự chạy và học cách đọc từng bảng.
Không. Bạn chỉ trả Credit khi lên đơn để gửi dữ liệu vào Google Form.
100 credit cho tài khoản mới

Bắt đầu với biểu mẫu của bạn

Import, cấu hình và xem chi phí trước khi chạy.

Tạo tài khoản miễn phí